BFrame
def BFrame(
    *values, keys:NoneType=None, names:NoneType=None, **fields
):
A native BPL value with shape, keys and names. An array that holds a function as a direct item is a FunctionArray.
def BFrame(
*values, keys:NoneType=None, names:NoneType=None, **fields
):A native BPL value with shape, keys and names. An array that holds a function as a direct item is a FunctionArray.
test_frame = BFrame(dict(col=[1,2,3]))
test_frame
┌→────────────┐
│ col:┌→────┐ │
│ │1 2 3│ │
│ └ₓ────┘ │
└∊────────────┘test_eq(BFrame, type(test_frame))bf = BFrame.read_csv("../data/toy.csv", encoding="UTF-8")
bf.df.head(3)| Number | City | Gender | Age | Income | Illness | |
|---|---|---|---|---|---|---|
| 0 | 1 | Dallas | Male | 41 | 40367.0 | No |
| 1 | 2 | Dallas | Male | 54 | 45084.0 | No |
| 2 | 3 | Dallas | Male | 42 | 52483.0 | No |
# bf.save_csv("../data/save_test.csv");head = bf.take(100)
head.take(2).df| Number | City | Gender | Age | Income | Illness | |
|---|---|---|---|---|---|---|
| 0 | 1 | Dallas | Male | 41 | 40367.0 | No |
| 1 | 2 | Dallas | Male | 54 | 45084.0 | No |
bf.head().df| Number | City | Gender | Age | Income | Illness | |
|---|---|---|---|---|---|---|
| 0 | 1 | Dallas | Male | 41 | 40367.0 | No |
| 1 | 2 | Dallas | Male | 54 | 45084.0 | No |
| 2 | 3 | Dallas | Male | 42 | 52483.0 | No |
| 3 | 4 | Dallas | Male | 40 | 40941.0 | No |
| 4 | 5 | Dallas | Male | 46 | 50289.0 | No |
bf.tail().df| Number | City | Gender | Age | Income | Illness | |
|---|---|---|---|---|---|---|
| 0 | 149996 | Austin | Male | 48 | 93669.0 | No |
| 1 | 149997 | Austin | Male | 25 | 96748.0 | No |
| 2 | 149998 | Austin | Male | 26 | 111885.0 | No |
| 3 | 149999 | Austin | Male | 25 | 111878.0 | No |
| 4 | 150000 | Austin | Female | 37 | 87251.0 | No |
MEAN = add.reduce_first / tally
MEAN(bf.head(100)["Income"])44362.88fanout↣(□, {f←↑⍺⋄f ⍵}⍤[0 ∞]⍤[∞ 2])RMSE = MEAN.under(square)
fn_dict=dict(mean=MEAN, rmse=RMSE)
fn_dict{'mean': +⌿÷≢, 'rmse': (+⌿÷≢)@⊼}head.groupby("Gender", "Income", rmse=RMSE)┌→───────────────┐
↓"Male"⌷ │
↓ Income│
│rmse 49632.10639│
│ │
│"Female"⌷ │
│ Income│
│rmse 40738.65853│
└~───────────────┘head.groupby("Gender", ["Age", "Income"], **fn_dict)┌→───────────────────────────┐
↓"Male"⌷ │
↓ Age Income│
│mean 44.57407407 48301.42593│
│rmse 45.66970793 49632.10639│
│ │
│"Female"⌷ │
│ Age Income│
│mean 45.30434783 39739.36957│
│rmse 46.73468128 40738.65853│
└~───────────────────────────┘windows docs with arg explanations: https://answerdotai.github.io/basedpl/glyphs/up-down-arrow.html
ts = BFrame(dict(price=[5,4.3,4.1,2,10,20,15,25]))
ts.rolling("price", size=3, mean=MEAN, rmse=RMSE).df| price | ||
|---|---|---|
| 0 | mean | 3.100000 |
| rmse | 3.807449 | |
| 1 | mean | 4.466667 |
| rmse | 4.483302 | |
| 2 | mean | 3.466667 |
| rmse | 3.619392 | |
| 3 | mean | 5.366667 |
| rmse | 6.345865 | |
| 4 | mean | 10.666667 |
| rmse | 12.961481 | |
| 5 | mean | 15.000000 |
| rmse | 15.545632 | |
| 6 | mean | 20.000000 |
| rmse | 20.412415 | |
| 7 | mean | 13.333333 |
| rmse | 16.832508 |
ts.rolling("price", size=4, step=2, mean=MEAN, rmse=RMSE).df| price | ||
|---|---|---|
| 0 | mean | 3.350000 |
| rmse | 3.882654 | |
| 1 | mean | 5.100000 |
| rmse | 5.901271 | |
| 2 | mean | 11.750000 |
| rmse | 13.500000 | |
| 3 | mean | 15.000000 |
| rmse | 17.677670 |
BFrame(dict(price=[5,4.3,4.1,2,10,20,15,25])).plot(mark="line", title="Price over time")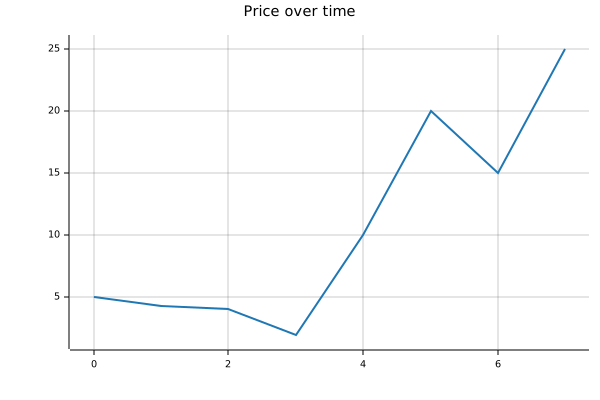
income = head["Income"]
income.hist_input(5).df| x | count | |
|---|---|---|
| 0 | 21417.9 | 6 |
| 1 | 31917.7 | 21 |
| 2 | 42417.5 | 27 |
| 3 | 52917.3 | 36 |
| 4 | 63417.1 | 10 |
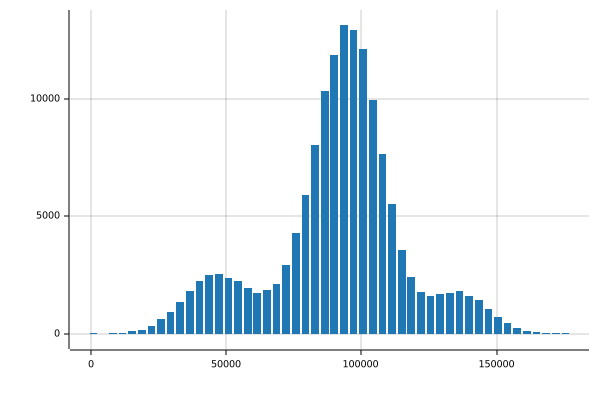
bf["Income"].hist()